对于许多交叉学科或文理综合类专业的硕博生来说,Scopus 数据库的检索证明同样是毕业答辩与评奖评优的“硬通货”。相比于老牌的 EI Compendex,Scopus 作为一个以海量吞吐和多学科交叉著称的引文数据库,其底层算法更加现代,整体的收录节奏通常也会更加轻快。
但“快”也是有前提条件的。一篇会议论文从会议现场的 PPT 汇报,到最终变成 Scopus 搜索框里的一条记录,到底需要经历多长时间?中间又有哪些容易被忽视的变量?
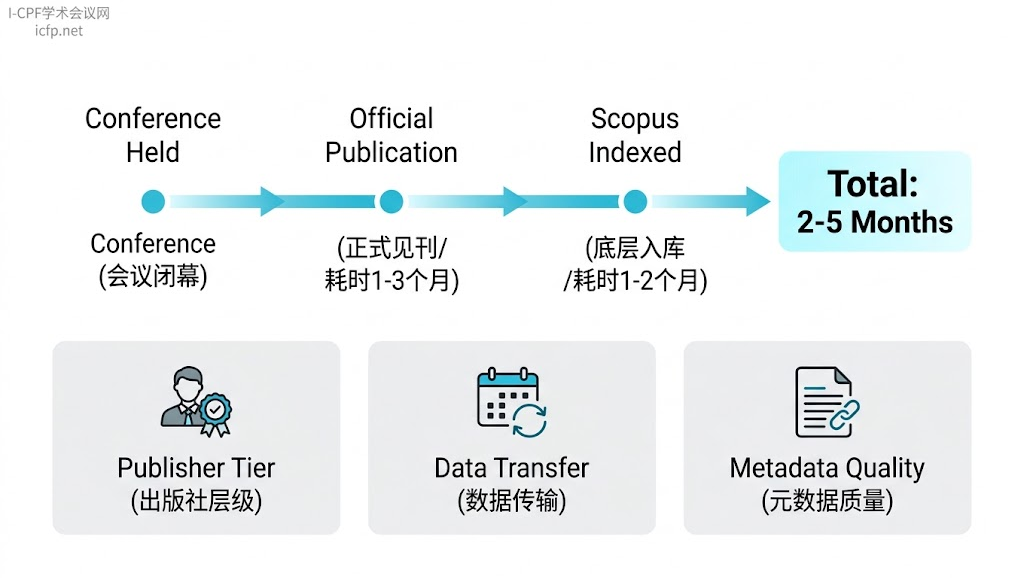
1. Scopus 收录的“标准时间线”拆解
要把文章送进 Scopus 的底层网络,必须严格遵循先“见刊(Publication)”后“检索(Indexing)”的先后顺序。我们以最常见的“会后出版模式”为例,为您倒推这条标准时间线:
-
第一段:会议闭幕到正式见刊(通常耗时 1 - 3 个月) 会议结束后,组委会收集所有作者的最终定稿交由出版社(如 Springer、IEEE、IOP 等)进行排版、版权审核。当文章在出版社的数字图书馆正式上线并拥有了 DOI 号时,这一阶段才算结束。
-
第二段:正式见刊到 Scopus 检索(通常耗时 1 - 2 个月) 文章见刊后,出版社的后台系统会通过 XML 数据流,将新论文集的元数据自动推送到 Elsevier(Scopus 母公司)的数据中心。Scopus 的机器爬虫接收到数据后,会开始解析文章标题、作者关联、尤其是参考文献列表,随后生成对应的 Scopus 记录(EID)。
综合预期:如果一切顺利,一篇常规的国际学术会议论文,从会议正式闭幕算起,大约需要 2 到 5 个月的时间 才能在 Scopus 数据库中查到。
2. 为什么同一批会议,有的检索快,有的却被拖延?(核心影响因素)
如果您发现自己的文章迟迟没有入库,往往是卡在了以下四个核心变量上:
-
出版商的级别与数据对接通道(最核心要素) Scopus 是爱思唯尔(Elsevier)自家的产品。如果您投的会议刚好是由 Elsevier 旗下出版(如 Procedia 系列),那数据基本是内部秒传,极快入库。其次是 IEEE、Springer、ACM 这种与 Scopus 建立了成熟 API 自动推流机制的顶级大厂,见刊后通常 3-4 周就能被 Scopus 抓取。但如果是一些极其冷门的小型独立出版机构,需要人工定期向 Scopus 提交数据包,那时间就会被无限期拉长。
-
元数据(Metadata)与参考文献的规范度 Scopus 本质上是一个“引文(Citation)”数据库。它的底层算法在抓取文章时,极其依赖标准化的参考文献格式。如果您的文章参考文献排版混乱、引用了大量无法溯源的中文非标准文献,Scopus 的爬虫在建立引文网状图谱时就会报错,从而导致这篇单篇文章被系统拦截并转入人工复核通道,大大拖慢收录进度。
-
会议的历史声誉与“试用期”审查 如果这是一个已经连续举办了十届的老牌会议,Scopus 系统通常会给予“免检放行”的信任评级,数据一到马上入库。但如果这是第一届或第二届举办的全新会议,Scopus 会启动更加严苛的学术合规性审查(抽查同行评审记录、查重率等),这往往会额外消耗 1-2 个月的时间。
-
欧美节假日与年底数据积压 数据库的运维和入库审核也受制于人工休假节拍。如果是下半年(11月-12月)召开的会议,见刊时刚好撞上欧美的圣诞节和新年长假,同时叠加全球各个出版商年底批量清库的庞大数据流,Scopus 的入库速度会肉眼可见地变慢。
给科研人员的时间规划建议
如果您手里有一篇会议论文指望着它能在明年的特定月份派上用场(比如 5 月份的高校毕业材料盲审),请务必在脑海中牢记 “6个月安全缓冲区” 这个概念。
假设您明年 5 月需要拿到 Scopus 查收查引报告,倒推回去,您最迟应该参加今年 11 月之前召开的学术会议。永远不要去赌数据库的极限入库速度,把充足的时间留给出版与数据流转,才是学术发表中最稳妥的策略。
上一篇
2027泰晤士世界大学排名发布
共话智慧教育与教育技术创新 | 第九届教育技术管理国际会议(ICETM 2026)在深圳举行
- 39
- 发布时间:2026.10.20
7所985大学,共同发起重磅平台
- 34
- 发布时间:2026.10.20
部分研究生不用再写传统学位论文!国务院学位办最新文件
- 42
- 发布时间:2026.10.20
2026年IEEE第26届通信技术国际会议(IEEE ICCT 2026) 在珠海举行
- 49
- 发布时间:2026.10.19
华南理工大学成立2个新学院、6个新研究院
- 132
- 发布时间:2026.10.12