满心欢喜地参加完国际会议,眼看着同一本论文集里别人的文章都陆续在 Engineering Village 或 Scopus 里查到了 Accession Number,唯独自己的文章搜了一遍又一遍,始终查无此文。这种“漏检”往往是科研萌新最容易崩溃的时刻。
数据库并不是做慈善的收容所,它们有着极其严格的底层机器过滤与人工抽检机制。如果您的文章迟迟不入库,通常是踩中了以下 5 个最致命的雷区。
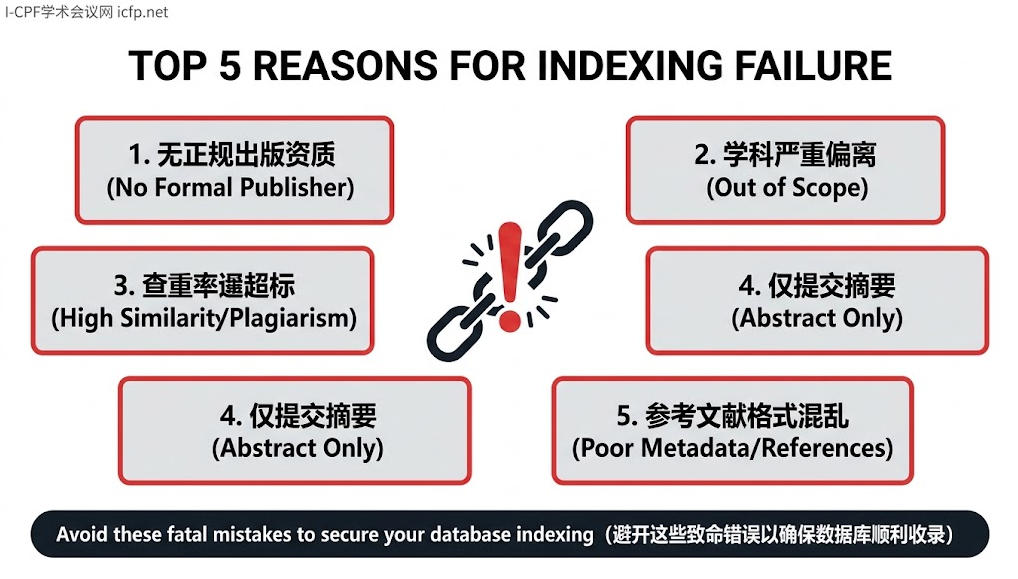
1. 会议本身没有走正规的“国际出版”流程
这是最彻底的“先天不足”。有些国内会议名字起得非常响亮,号称“EI检索”,但主办方为了省钱省事,会后根本没有把论文集移交给 IEEE、Springer 或 ACM 等正规国际出版商进行排版。他们只是印了一本内部交流的册子,或者发了一个毫无版权效力的 U 盘。
这种连国际标准书号(ISBN)和 DOI 都没有的“灰色文献”,连出版界的大门都没迈过去,底层的检索数据库爬虫根本无从抓取,自然永远无法检索。
2. 您的文章被判定为“学科严重偏离(Out of Scope)”
这在交叉学科投稿中极其常见。以工科界的硬通货 EI Compendex 为例,它的核心宗旨是只收录“工程与应用科学”。
假设您参加的是一个计算机与大数据主题的会议,但您的论文内容是用统计学方法分析某地区的人口生育率下降原因,通篇都是社会学分析,没有任何算法优化或工程应用的代码部署。当出版社把整本论文集发给 EI 后,EI 的数据清洗系统会敏锐地抓取到这篇文章的关键词偏离了工程主线。此时,哪怕整本会议集有 99 篇文章都被检索了,您这篇纯社科文章也会被单独“剔除出局”。
3. 查重率超标或触发学术不端预警
国际出版大厂(如 IEEE 的 CrossCheck 系统)对查重率有着严格的红线,通常全文重复率不能超过 20%-30%,且单篇重复率必须控制在 5% 以内。
有些作者存在侥幸心理,把几年前发表过的中文文章直接机器翻译成英文,或者对已发表的会议论文原封不动地换个标题再次提交(自我抄袭)。这种文章哪怕混过了会议主办方的初审,在移交数据库入库的最后一道人工抽检时,一旦被系统比对出高重复率,不仅会被立刻中止检索,甚至会面临被出版社追溯撤稿(Retraction)的严重学术污点。
4. 仅提交了摘要,或文章篇幅过短
EI 和 Scopus 这种级别的权威引文数据库,追求的是实质性的学术论证过程(完整的研究背景、实验数据、推导过程与结论)。
如果您在会议注册时只提交了 Abstract(摘要),或者提交的所谓“全文”极其敷衍,连图表算在内仅仅只有 2 到 3 页。这种长度的文档会被数据库系统自动归类为“Non-substantive(无实质内容的短文)”或“会议导读”。绝大多数情况下,此类短文会被系统自动过滤,不予分配正式的检索号。
5. 参考文献格式极度混乱,导致引文网状图谱断裂
Scopus 作为一个极度依赖“引文(Citation)”生态的数据库,它的爬虫算法在抓取您的文章时,会花大量算力去解析您文末的参考文献列表(References)。
如果您的参考文献格式乱七八糟(没有统一遵循 APA 或 IEEE 格式),或者引用了大量没有英文翻译的纯中文非核心期刊,导致 Scopus 的解析器无法识别出对应的源头文献。这种劣质的元数据(Metadata)会触发机器抓取错误,导致文章被无限期挂起等待人工复核,甚至直接被判定为低质量论文而拒绝收录。
学术检索的本质是一场严密的算法筛选。在投稿前认准带有权威出版商背书的会议,死磕工程应用的学科主干,同时把控好查重率与学术写作规范,您的文章才不会在最后一步被数据库冷酷地拒之门外。
上一篇
学术会议论文被Scopus收录需要多长时间?影响检索周期的因素全解析
共话智慧教育与教育技术创新 | 第九届教育技术管理国际会议(ICETM 2026)在深圳举行
- 39
- 发布时间:2026.10.20
7所985大学,共同发起重磅平台
- 34
- 发布时间:2026.10.20
部分研究生不用再写传统学位论文!国务院学位办最新文件
- 42
- 发布时间:2026.10.20
2026年IEEE第26届通信技术国际会议(IEEE ICCT 2026) 在珠海举行
- 49
- 发布时间:2026.10.19
华南理工大学成立2个新学院、6个新研究院
- 132
- 发布时间:2026.10.12