在将学术手稿提交至国际学术会议(如 IEEE、ACM、Springer 旗下会议)或 SCI/SSCI 期刊之前,绝大多数编辑部都会先运行一遍查重系统(如 iThenticate / Turnitin 或 Crossref Similarity Check)。
许多作者在拿到查重报告时,常面对一整页触目惊心的大面积标红(Similarity Flags):
-
仅仅是描述常用的实验基线算法,整段直接被判定为 90% 抄袭;
-
尝试用词典换了几个同义词,结果重新查重时依然被整行标红;
-
盲目使用全自动降重软件,导致生成的句子语法混乱、生造词频现,甚至彻底扭曲了原作者的学术论点。
改写标红内容并不是简单的“同义词填字游戏”,而是需要在保全学术严谨性的前提下,对句子语法骨架与逻辑流向进行深度重构。
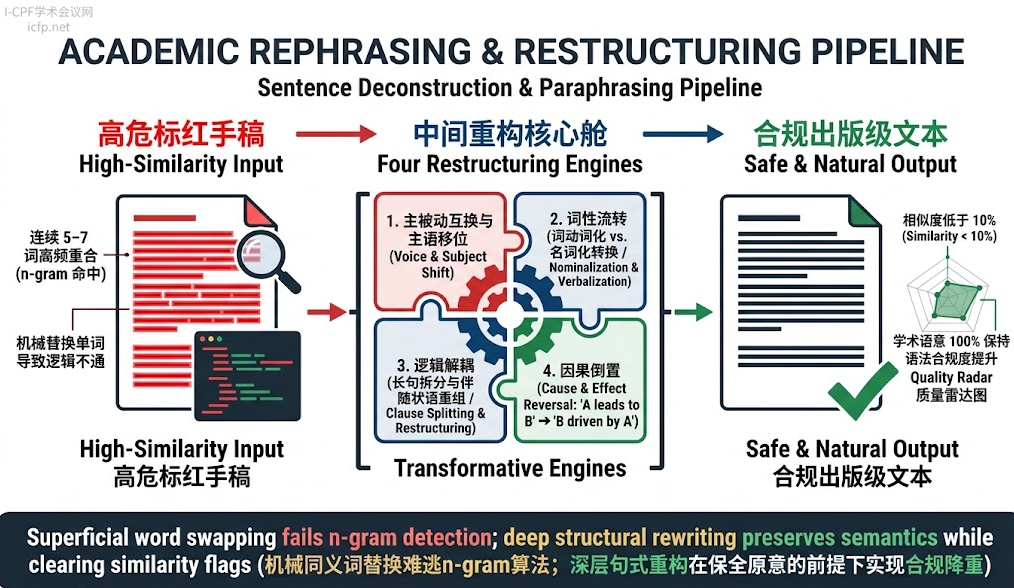
1. 为什么“单纯替换同义词”骗不过现代查重系统?
许多初学者修改标红时最常用的做法是:把标红句子里的单词查字典换掉,比如把 shows 换成 demonstrates,把 important 换成 crucial。
这种改法往往收效甚微,原因在于主流学术查重系统(如 iThenticate / Turnitin)采用的是 n-gram 序列比对算法:
-
连续词窗判定机制:系统并不是孤立扫描单个词,而是以 5 到 7 个连续单词构成的序列(Window of Words) 为单位与全球数亿篇文献库进行指纹匹配。
-
句法骨架锁定:如果只改动句中的一两个形容词,但整个句子的主谓宾结构、功能虚词(介词、连词)与语序排布保持不变,算法仍能在概率哈希匹配中轻易判定这一序列为“改写抄袭(Paraphrase Plagiarism)”。
-
学术生硬感与逻辑失真:英语学术词汇在特定学科场景下具有精准的外延与内涵。盲目使用不符合科研语境的生僻同义词(如将实验中的
small error强行替换成文学词汇puny error),不仅无法降低核心特征重合,反而会在同行评审阶段给审稿人留下极差的印象。
2. 深度句式重构的四大高阶降重法则
真正高效且合规的降重,核心在于打破原句的语法骨架,用全新的表述逻辑重塑信息表达。
法则一:主语重置与主被动语态互换(Subject & Voice Shift)
改变句子的观察视角,把句子关注的焦点(主语)转移到受体、实验数据或方法本身上。
-
标红原句(被动语态):
"A novel convolutional neural network was proposed by Smith et al. to extract multi-scale features from corrupted images."
-
重构方案(以方法或特征为主语重塑):
"To capture multi-scale representations under noisy conditions, Smith et al. introduced an alternative convolutional architecture."
(改写要点:将动词不定式目的状语前置,把原句的被动语态改为主谓主动,核心结构彻底解构。)
法则二:词性流转(名词化与动词化互换)
学术英语极度偏爱“名词化(Nominalization)”。在降重时,通过在动词、名词、形容词之间进行词性转换,可以直接瓦解原句的短语搭配链。
-
标红原句(名词短语堆叠):
"The evaluation of the model performance depends on the accurate measurement of latency and throughput."
-
重构方案(动词化引导从句):
"Accurately measuring how latency and throughput behave is fundamental to assessing the proposed model."
(改写要点:将名词短语
evaluation of...改为动名词assessing,将measurement of...改为动词短语accurately measuring,彻底粉碎原句词序。)
法则三:因果逻辑倒置与连词重置(Causal Inversion)
学术论文中充斥着大量的因果推导语句。打破“因为 A,所以 B”的固定单向模式,逆向组织逻辑。
-
标红原句(正向因果:A 导致 B):
"Because the gradient vanishes during backpropagation, deep networks frequently suffer from severe training instability."
-
重构方案(逆向归因:B 根源于 A):
"Severe instability during deep network training typically stems from gradient attenuation across backward layers."
(改写要点:使用
stems from/originates in代替Because... suffer from...,前因后果在物理空间上对调。)
法则四:长难句拆分与伴随分词短语嵌套(Clause Splitting & Merging)
如果原句是一个包含多个 which 或 that 的复合长句,拆分成两个短句,或利用 -ing / -ed 分词短语进行修饰压缩。
-
标红原句:
"The algorithm calculates the distance matrix between all nodes, which requires extensive memory and results in poor scalability on large graphs."
-
重构方案:
"Calculating the full pairwise distance matrix demands substantial memory resources. Consequently, the approach demonstrates limited scalability when applied to large-scale graph topologies."
(改写要点:直接在逻辑转折处断开为两句话,引入
Consequently承接,从词法、句法两个维度彻底脱敏。)
3. 辅助降重工具推荐与合规使用边界
在手动改写的同时,合理利用数字工具能显著提升工作效率。但必须明确工具的定位是“灵感激发”,而非“全盘替代”。
| 工具名称 | 核心优势 | 推荐应用场景 | 局限与避坑提示 |
| Wordtune | 提供多种整句重写建议,语意连贯度极高 | 针对反复标红的核心观点句寻找新的表达句式 | 免费版每日重写次数有限 |
| QuillBot | 支持 Academic / Formal 多种改写风格模式 | 适合针对长段落进行初步结构梳理 | 机械换词比例略高,改写后必须人工通读修正错误术语 |
| Power Thesaurus | 实时筛选学术上下文高频同义词,杜绝生僻乱码词 | 寻找特定动词与连接词的专业替代品 | 无法处理整句逻辑重塑 |
| DeepL 双向回译 | 英 $\rightarrow$ 德/法 $\rightarrow$ 英 双向翻译,自动提供新语序 | 寻找完全打破汉语思维的自然英文语序 | 容易误改核心专业专有名词,需锁定术语 |
工具合规红线:
-
绝不能过度依赖未受审视的 AI 润色:许多国际顶会(如 IEEE / ACM 现行政策)明确规定,手稿必须由作者本人负责真实性与学术规范。直接将整篇论文丢给大模型自动重写,极易引入未声明的“AI 幻觉”并留下机械的 AI 句式特征。
-
专有名词保护(No-Touch Terms):算法专属名称(如
ResNet-50、Adam Optimizer、Cross-Entropy Loss)、数据集、数学参数符号,在工具改写过程中必须被锁定,严禁替换为奇怪的相近词。
4. 论文核心高危章节降重实战范例
范例一:Introduction(研究背景与前人工作归纳)
-
标红段落:
"In recent years, deep learning has achieved great success in the field of natural language processing, especially with the emergence of large-scale pre-trained language models."
-
降重改写后:
"The landscape of natural language processing has undergone a transformative shift recently, largely propelled by the widespread adoption of scaled pre-trained foundations."
(解析:去除了泛滥陈旧的
achieved great success与in the field of,用transformative shift和largely propelled by赋予段落更高阶的学术语体。)
范例二:Methodology(常用算法与实验步骤描述)
-
标红段落:
"The collected dataset was randomly split into three parts: 70% for training, 15% for validation, and the remaining 15% for testing."
-
降重改写后:
"We partitioned the aggregated samples according to a 7:1.5:1.5 distribution, assigning them respectively to model optimization, hyperparameter tuning, and final metric evaluation."
(解析:不再重复机械的
training / validation / testing,改用其实际承载的功能动作model optimization / hyperparameter tuning / evaluation进行降重表达。)
5. 常见降重认知误区与底线警告
-
误区一:使用特殊空格或隐藏字符欺骗查重 部分网络黑产教程声称“在单词间插入白色隐藏符号或西里尔字母跳过系统检测”。这种行为属于严重的学术不端。现在的 Turnitin 等系统能直接识别异常 Unicode 编码并触发强制标灰警报,一旦被出版社发现,会直接以“恶意伪造手稿”实施 Desk Reject 并通报单位。
-
误区二:认为“引用了就绝对不算重合” 很多作者认为只要在句尾打了
[1],查重系统就会自动扣除该部分。事实上,查重系统虽然会单独出具一份“排除引用后”的报告,但如果正文整段大面积照抄前人文献的原文,即使打了引用标号,在学术道德审查中依然会被判定为过度直接引用(Over-quotation)。正规做法依然必须是对引用的观点进行消化吸收后的意译(Paraphrasing)。 -
查重率安全线参考:
-
总相似度(Overall Similarity Index):主流国际会议与 SCI 期刊普遍要求控制在 15% 至 20% 以下。
-
单篇来源相似度(Single-source Similarity):单篇文献引用重合率必须严格低于 1% 至 2%。如果全文总查重率只有 12%,但有 8% 集中来自于某一篇特定论文,该文章依然会被编辑部判定为严重涉嫌抄袭。
-
掌握核心句式的拆解与重构法则,摆脱对机械同义词的依赖,既能让查重率稳健降至安全线以下,更能全面提升整篇学术论文的语言水准与逻辑质感。
上一篇
顶会论文代码复现指南:如何在GitHub与Papers With Code快速找到开源代码?
聚焦智能通信与信息处理前沿,2026年第12届通信和信息处理国际会议(ICCIP 2026)在海南陵水举行
- 14
- 发布时间:2026.11.16
聚焦电力能源与智能系统前沿,2026年电力能源、电力电子与智能系统国际会议(PEIS 2026)在南京举行
- 100
- 发布时间:2026.11.10
第十五届计算与模式识别国际会议(ICCPR 2026)在无锡举行
- 170
- 发布时间:2026.11.03
选人不选项目,最高2500万元/人!2027新基石研究员项目指南发布
- 137
- 发布时间:2026.11.03
西南民族大学成立人工智能学院
- 150
- 发布时间:2026.11.02