在将实验结果整理为图表投向国际学术会议或期刊时,同行评审专家与编辑部对统计学显著性分析(Statistical Significance Analysis)的严谨度有着近乎苛刻的要求。
许多科研新手在准备图表与正文结果时,常陷入以下典型硬伤:
-
柱状图上挂了误差棒(Error Bar),但图注(Figure Caption)通篇没有交代它到底代表标准差(SD)还是标准误(SEM);
-
正文中直接出现 “$p = 0.000$” 的荒谬写法;
-
为了让误差棒“看起来又短又整齐、数据更漂亮”,故意将 SD 替换为 SEM,却未说明样本量 $n$;
-
多组对比时随意多次运行双样本 $t$ 检验,引发严重的“多重比较第一类错误膨胀”。
掌握规范的统计学检验逻辑与国际通行的报告规范,是保障科研结论可信度的基石。
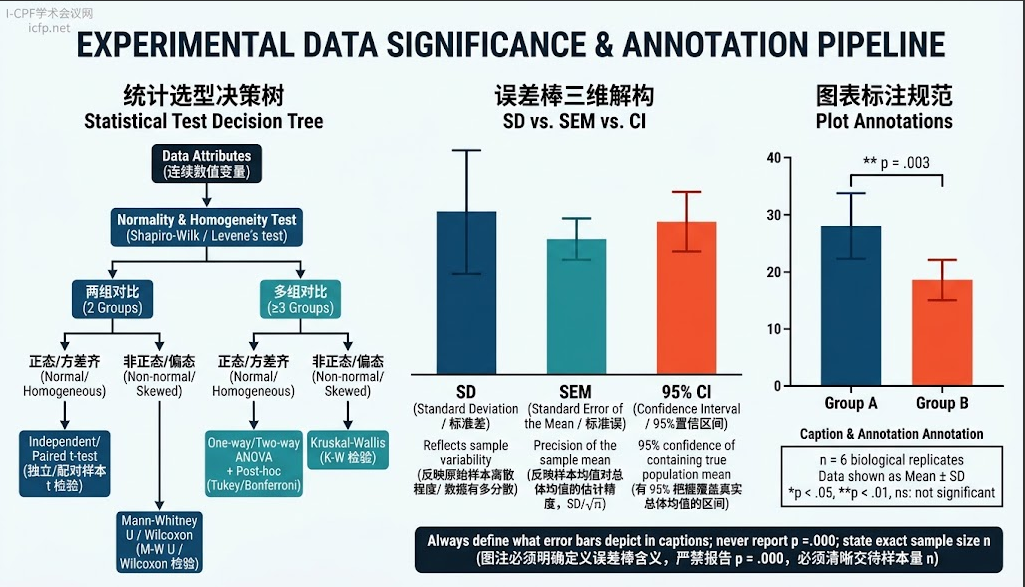
1. 显著性分析第一步:如何挑选正确的检验方法?
显著性分析的核心在于推翻虚无假设(Null Hypothesis, $H_0$),检验观察到的组间差异究竟是真实效应还是随机误差导致的。选择统计方法绝不能凭空猜测,必须严格遵循以下决策路径:
[数据输入] ➔ 检验正态性 (Shapiro-Wilk) 与方差齐性 (Levene's test)
   │
   ├─► 满足正态与方差齐性 (参数检验 / Parametric)
   │      ├─► 两组对比: 独立样本 t 检验 (两组独立) / 配对 t 检验 (自身前后对照)
   │      └─► 三组及以上: 单因素/双因素方差分析 (ANOVA) + 事后检验 (Post-hoc: Tukey HSD)
   │
   └─► 偏态分布 / 严重异方差 (非参数检验 / Non-parametric)
          ├─► 两组对比: Mann-Whitney U 检验 (独立) / Wilcoxon 符号秩检验 (配对)
          └─► 三组及以上: Kruskal-Wallis 检验 + Dunn's 事后校正
① 参数检验的前提验证
在执行 $t$ 检验或方差分析(ANOVA)前,必须在 SPSS、GraphPad Prism 或 Python 中进行两项前置检验:
-
正态性检验(Normality Test):小样本($n < 50$)推荐 Shapiro-Wilk test。若 $p > 0.05$,表明数据符合正态分布。
-
方差齐性检验(Homogeneity of Variance):运行 Levene's test。若 $p > 0.05$,表明各组方差基本一致。若出现异方差,两组对比须改用 Welch's $t$-test。
② 警惕“多重检验陷阱”(Multiple Comparisons)
当实验包含 3 组或更多组别(如对照组、低剂量组、高剂量组)时,绝对不能在组间两两重复执行独立的 $t$ 检验。
-
每做一次 $t$ 检验,犯第一类错误(假阳性)的概率是 $\alpha = 0.05$。若进行 3 次两两比对,整体假阳性率会迅速飙升至 $1 - (1 - 0.05)^3 \approx 14.3\%$。
-
规范做法:必须先运行 One-way ANOVA(单因素方差分析) 确认全局存在显著差异,随后使用 Tukey's HSD 或 Bonferroni 校正 进行事后多重两两比较。
2. 核心概念辨析:误差棒(Error Bar)到底该用 SD、SEM 还是 CI?
在绘制柱状图、散点图或折线图时,误差棒的选择直接决定了数据的科学传达属性。国际顶刊(如 Nature 系列期刊的统计指引)强制要求作者必须在图注中明确指出误差棒所代表的统计学量纲。
| 误差棒类型 | 计算公式 | 统计学本质 | 适用场景与优劣势 |
| 标准差(SD, Standard Deviation) | $s = \sqrt{\frac{\sum (x_i - \bar{x})^2}{n - 1}}$ | 描述性统计量:反映原始样本个体之间的离散程度与变异范围。 | 基础实验与工程测试首选。不受样本量 $n$ 膨胀的影响,能够真实展示数据波动。 |
| 标准误(SEM, Standard Error of Mean) | $\text{SEM} = \frac{\text{SD}}{\sqrt{n}}$ | 推断性统计量:反映由样本均值推断总体均值时的抽样误差与估计精度。 | 样本量 $n$ 很大时,SEM 会变得极小。常被部分研究者滥用于掩盖原始数据的巨大离散性,需谨慎使用。 |
| 95% 置信区间(95% CI) | $\bar{x} \pm t_{crit} \times \text{SEM}$ | 推断性统计量:有 95% 的概率包含真实总体均值的理论区间。 | 临床医学、生物学首选。如果两组的 95% CI 互不重叠,通常预示着存在统计学显著性差异。 |
选型黄金法则:
-
如果研究目的是向读者展示实验测量系统本身的稳定度、或者实验样本群体的真实分布分散情况,一律选用 $\text{Mean} \pm \text{SD}$;
-
如果研究目的是评估两组总体均值是否存在显著差异的推断精度,可选用 $\text{Mean} \pm \text{SEM}$ 或 95% CI;
-
不可饶恕的错误:在图上绘制了误差棒,但图注中只字不提它代表 SD 还是 SEM,且未交代样本量 $n$。
3. 论文中 P 值(P-value)的书写与报告规范
P 值是假设检验的核心输出,其在正文与表格中的书写排版必须遵循严谨的学术出版规范(以 APA 7th 与各大出版社通用规范为准):
① 字母排版与空格规范
-
大小写与正斜体:$p$ 必须小写且斜体(p),大写 $P$ 常被用于指代概率分布或功率参数。
-
数学连接符留白:等号
$=$或不等号$<$的两侧必须留出一个半角空格。-
错误写法:
p<0.05、P=0.03 -
正确写法:
p = .031(APA 规范)或p = 0.031(理工科通用规范)
-
② 彻底杜绝 “p = .000” 的低级错误
在 SPSS 等统计软件输出结果时,如果计算出的 P 值极其微小,软件表格常自动截断显示为 .000。
-
致命误区:概率在数学上绝不可能为 0,
.000只是软件的显示精度舍入。如果在论文中照抄书写$p = .000$或$p = 0.000$,会直接暴露作者缺乏统计学常识。 -
正确写法:必须书写为 $p < .001$(或 $p < 0.001$)。
③ 优先报告“精确 P 值”(Exact P-value)
现代学术界不提倡将所有数据简单粗暴地切分为“显著($p < .05$)”和“不显著($p \ge .05$)”。
-
除了极微小的数值(如 $p < .001$)外,正文与表格中应尽量给出保留 2 至 3 位小数的精确值(例如:p = .024 或 p = .072)。这能让读者更客观地评估统计证据的强度,而非依赖硬性的人为阈值。
4. 图表中的显著性标注实操(星号、连线与紧凑字母法)
在插图中展示组间显著性对比时,学术界通行的视觉表达方案主要有两种:
方案 A:横跨连线支架与星号标注法(适用于对比组较少,$\le 4$ 组)
在柱状图或箱线图上方,使用整齐的横线与竖向下折角连接需要对比的两个组,并在横线上方标注星号:
-
星号等级约定俗成对照表:
-
$\text{ns}$ (Not Significant):$p \ge 0.05$(无显著性差异,通常可省略连线以精简版面)
-
$*$ :$p < 0.05$(存在显著性差异)
-
:$p < 0.01$(高度显著)
-
$***$ :$p < 0.001$(极度显著)
-
$****$ :$p < 0.0001$(部分软件如 GraphPad Prism 细分档位)
-
方案 B:紧凑字母标记法(Compact Letter Display, CLD,适用于多组复杂对比)
当实验包含 5 个以上的实验组或不同处理梯度时,图面上堆叠几十条交叉连线会导致版面完全崩溃。此时应使用字母标记法标注在柱头上方:
-
标注规则:
-
凡是含有相同字母的组别,代表两两比较无显著差异($p \ge 0.05$);
-
凡是字母完全不同的组别,代表两两比较具有显著差异($p < 0.05$)。
-
-
示例:A 组标记为
a,B 组标记为b,C 组标记为ab。-
表明 A 组与 B 组差异显著(字母完全不同);
-
C 组与 A 组(共享字母 a)、C 组与 B 组(共享字母 b)之间均无显著性差异。
-
5. Python 自动化绘制带误差棒与显著性检验图表
使用 Python 的 scipy 进行检验、搭配 seaborn / matplotlib 绘图,可以实现高质量矢量图的输出:
import matplotlib.pyplot as plt
import numpy as np
from scipy import stats

# 1. 模拟实验数据 (对照组 vs 实验处理组)
np.random.seed(42)
control = np.random.normal(loc=50, scale=6, size=8)   # n = 8
treatment = np.random.normal(loc=65, scale=7, size=8) # n = 8

# 2. 统计检验 (双样本双尾独立 t 检验)
t_stat, p_val = stats.ttest_ind(control, treatment)

# 计算均值与标准差 (Mean and SD)
means = [np.mean(control), np.mean(treatment)]
stds = [np.std(control, ddof=1), np.std(treatment, ddof=1)]

# 3. 创建 IEEE 单栏标准画布 (3.5 英寸)
fig, ax = plt.subplots(figsize=(3.5, 3.2), dpi=300)
x_pos = [0, 1]
labels = ['Control', 'Treated']

# 绘制柱状图并挂载标准差误差棒 (capsize 设定横杠宽度)
bars = ax.bar(x_pos, means, yerr=stds, capsize=4, width=0.5,
              color=['#4C72B0', '#DD8452'], edgecolor='black', linewidth=0.8,
              error_kw={'elinewidth': 1.0, 'ecolor': 'black'})

# 4. 动态绘制显著性连线支架与标注
y_max = max(means[0] + stds[0], means[1] + stds[1])
bar_top = y_max + 4
h = 2

# 画横折线
ax.plot([0, 0, 1, 1], [bar_top, bar_top + h, bar_top + h, bar_top],
        color='black', linewidth=1.0)

# 判断显著性星号并标注
if p_val < 0.001:
    sig_label = '***'
elif p_val < 0.01:
    sig_label = '**'
elif p_val < 0.05:
    sig_label = '*'
else:
    sig_label = 'ns'

# 标注星号及精确 P 值
ax.text(0.5, bar_top + h + 1, f'{sig_label} (p = {p_val:.3f})',
        ha='center', va='bottom', fontsize=8, fontweight='bold')

# 5. 坐标轴与边界优化
ax.set_ylabel('Cell Viability (%)', fontsize=8.5)
ax.set_xticks(x_pos)
ax.set_xticklabels(labels, fontsize=8)
ax.set_ylim(0, bar_top + h + 12)
ax.tick_params(direction='in', length=3)

plt.tight_layout()
plt.savefig('significance_plot.pdf', format='pdf', bbox_inches='tight')
plt.show()
6. 提交前的统计学自查清单(Sanity Checklist)
在将论文正式提交审稿前,对照以下清单逐项复核图表与文段:
| 自查项目 | 规范要求 | 常见失误排查 |
| 误差棒定义 | 每一个出现误差棒的图题(Caption)必须写明是 SD 还是 SEM | 遗漏定义,仅写“bars represent error”属于严重不合规。 |
| 真实样本量标注 | 必须明确指出 $n$ 的具体数值及其生物学/物理学意义 | 明确标注“$n = 6$ independent biological experiments”而非模糊的“$n = 6$”。 |
| 正态性前提交代 | 在方法论(Methodology)章节交代进行了正态与齐性检验 | 默认使用参数 $t$ 检验却对分布形态只字不提。 |
| P 值书写格式 | $p$ 字母必须小写且斜体,两端留空格;杜绝 $p = .000$ | 检查有无笔误写成大写正体 $P<0.05$ 或软件截断的 $p = 0.000$。 |
| 星号定义完整 | 图注末尾必须完整列出所有使用的星号定义 | 确保附带“$*p < .05, **p < .01, ***p < .001, \text{ns: not significant}$”。 |
通过严密的前提假设检验、严禁遮蔽波动的规范误差棒选择,搭配标准化的 P 值书写与支架标注,能够确保您的实验数据在同行评审中展现出无懈可击的统计公信力与学术水准。
上一篇
英文学术论文语法检查:QuillBot、Grammarly与Writefull科研润色横向测评
聚焦电力能源与智能系统前沿,2026年电力能源、电力电子与智能系统国际会议(PEIS 2026)在南京举行
- 0
- 发布时间:2026.11.10
第十五届计算与模式识别国际会议(ICCPR 2026)在无锡举行
- 90
- 发布时间:2026.11.03
选人不选项目,最高2500万元/人!2027新基石研究员项目指南发布
- 81
- 发布时间:2026.11.03
西南民族大学成立人工智能学院
- 91
- 发布时间:2026.11.02
2026年第九届电力与能源应用国际会议(ICPEA 2026)暨第二届IEEE PCCC长三角论坛在合肥举行
- 125
- 发布时间:2026.10.30